Im ersten Teil dieser Serie hat Nikolina erklärt, wie steigende Kosten und die Grenzen von Legacy-Systemen im AI-Zeitalter Organisationen zum Lakehouse treiben – einem einzigen, skalierbaren Zuhause für Daten, Analytics und AI. Sie hat die mehrphasige Roadmap für die Migration von einem Legacy-Data-Warehouse zu einer modernen Lakehouse-Architektur skizziert, von der ersten Bewertung und dem Architekturdesign über die Daten- und ETL-Migration bis zur abschließenden Optimierung.
In diesem zweiten Blog richten wir den Fokus auf die technische Umsetzung der ETL-Migration. Wir steigen in eine der komplexesten und kritischsten Phasen des Migrationsprozesses ein: die Migration von ETL-Workloads. Konkret geht es darum, Databricks Lakebridge, das Migrationstool von Databricks, für die Migration von Informatica-PowerCenter-ETL-Logik und einem klassischen Oracle Data Warehouse auf eine moderne Databricks-Lakehouse-Plattform einzusetzen.
Anhand repräsentativer Workloads zeigen wir, wie sich Lakebridge in den Migrationsprozess einfügt, wo es die ETL-Migration und -Modernisierung beschleunigt und vereinfacht und wo weiterhin zusätzlicher Aufwand und Redesign nötig sind.
Im dritten Blog der Serie haben wir den ETL-Migrationsprozess weiter verbessert und automatisiert, indem wir Lakebridge um Jarvis, unser internes LLM-Tool, ergänzt haben. Jarvis half uns, den transpilierten Code zu verfeinern, verbleibende Lücken zu schließen und die Pipelines näher an die Produktionsreife zu bringen.
Vorgehen und Umfang
Um die Fähigkeiten von Databricks Lakebridge vollständig zu bewerten, haben wir zunächst eine repräsentative Auswahl von Informatica-PowerCenter-XML-Mappings aus einem laufenden ETL-Migrationsumfang getroffen, basierend auf den Komplexitätswerten des Lakebridge Analyzer, wie im Migrationsprozess auf dem Bild unten dargestellt.
Anschließend haben wir mit der Transpiler-Engine von Databricks Lakebridge die Informatica-PowerCenter-ETL-Mappings in Databricks-PySpark- und Spark-SQL-Skripte umgewandelt. Zum Schluss haben wir bewertet, wie gut der Transpiler die ursprüngliche Logik erfasst und übersetzt hat, und so einen ausgewogenen Blick auf seine Stärken und aktuellen Grenzen gewonnen.
Bevor wir in die Details unserer Bewertung einsteigen, schauen wir uns zuerst genauer an, was Databricks Lakebridge ist, welche Kernkomponenten es hat und welche Rolle es im gesamten Migrationsprozess spielt.
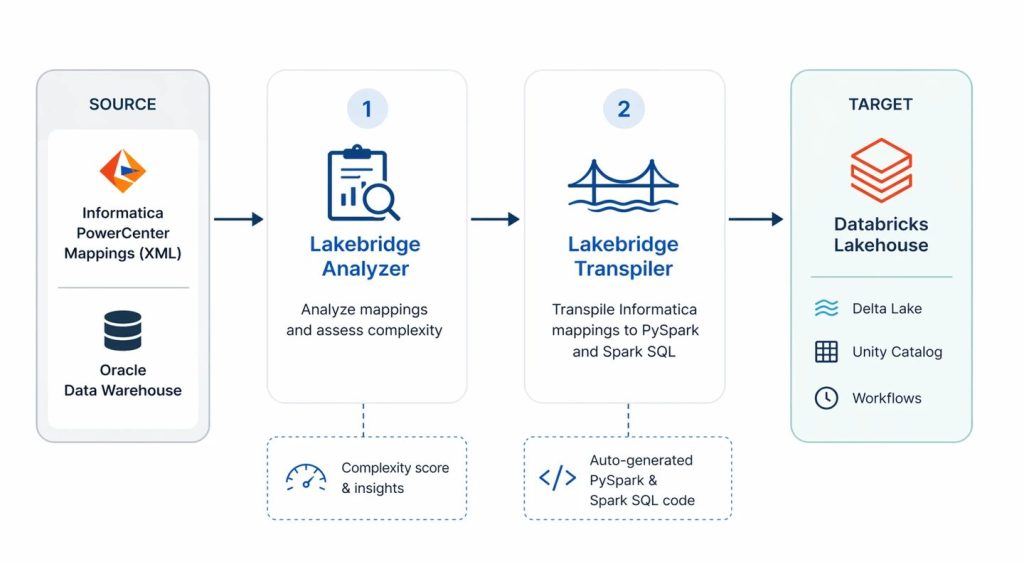
Databricks Lakebridge
Manuelle ETL-Migrationen sind in der Regel komplex, mühsam, zeitaufwendig und langsam, weil die Logik von Hand von einer Plattform auf eine andere übertragen wird. Mit der Zahl der ETL-Workloads wächst der Aufwand deutlich – und mit ihm das Fehlerrisiko. Die Migration zu Databricks kann aber viel schneller und automatisierter ablaufen, wenn man ein Tool wie Databricks Lakebridge nutzt, das genau diesen Prozess straffen und vereinfachen soll.
Databricks Lakebridge ist ein Migrations-Toolkit, das den Umzug von Legacy-Data-Warehouse-Workloads zu Databricks automatisiert. Es gliedert die Migration in drei Hauptphasen:
- Assessment-Phase (Profiler und Analyzer) – bewertet Umfang und Komplexität der Migration
- Transpilierungs- Phase (Transpiler) – wandelt Code des Quellsystems mit austauschbaren Engines in Databricks-kompatiblen Code um
- Reconciliation-Phase (Reconciler) – validiert die Ergebnisse durch den Vergleich der Ausgaben von Quellsystem und Databricks
Laut Databricks lassen sich mit Databricks Lakebridge bis zu 80 % des Migrationsaufwands automatisieren und die Umsetzungszeit bis zu halbieren.
In diesem Blog konzentrieren wir uns vor allem auf Fähigkeiten und Grenzen der wichtigsten Phase des Prozesses – der Transpilierungsphase –, denn dort findet die eigentliche Umwandlung Ihrer bestehenden Logik in Databricks-kompatiblen Code statt.
Bevor jedoch irgendetwas umgewandelt werden kann, muss man zuerst Größe, Umfang und Komplexität dessen verstehen, was migriert werden soll. Hier kommt der Lakebridge Analyzer ins Spiel. Stellen Sie ihn sich als Tool vor, das einen Schritt zurücktritt und Ihnen ein klares technisches Bild Ihrer aktuellen Umgebung liefert.
Assessment-Phase: Lakebridge Analyzer
Bevor Code umgewandelt wird, müssen wir den bestehenden Umfang der ETL-Migration klar verstehen. Wie Nikolina im vorherigen Blogbeitrag beschrieben hat, ist die Assessment-Phase entscheidend, um ein vollständiges Bild der aktuellen Landschaft zu gewinnen – aus fachlicher wie aus architektonischer Sicht.
In Databricks Lakebridge übernimmt diese Aufgabe die Komponente Analyzer, die sich speziell auf die technische Seite dieser Bewertung konzentriert. Ihre Aufgabe ist es, Transparenz über Inventar, Komplexität und Abhängigkeiten bestehender ETL- und SQL-Workloads zu schaffen.
Dazu scannt der Analyzer exportierte Quellmetadaten aus ETL-Pipelines und SQL-Assets und fasst diese Informationen in einem strukturierten Inventarbericht zusammen (Excel, optional mit JSON-Ausgabe). So lässt sich das zugrunde liegende System leichter verstehen und bewerten.
Grob gesagt wirft der Analyzer nicht einfach Rohmetadaten aus, sondern ordnet sie in einige zentrale Erkenntnisse, die für die Migrationsplanung sofort nützlich sind, wie das Bild unten zeigt.
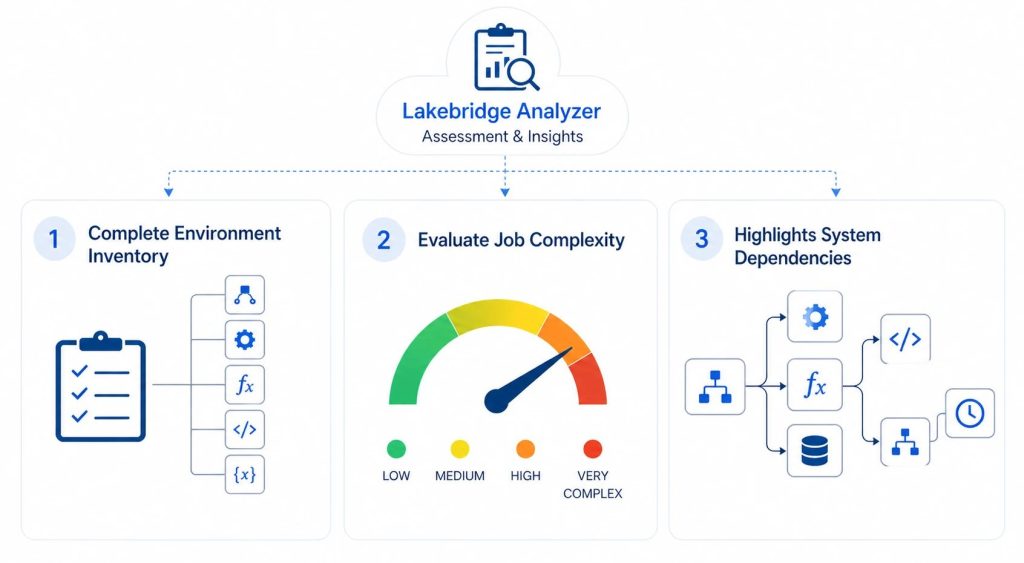
Erstens liefert er ein vollständiges Inventar Ihrer Umgebung. Dazu gehört alles von Mappings und Transformationen bis zu Funktionen, Programmen und dynamischen Variablen. Statt alles manuell zusammenzusetzen, erhalten Sie einen strukturierten Überblick darüber, was in Ihrem Legacy-System tatsächlich existiert. In Informatica PowerCenter bedeutet das zum Beispiel eine klare Aufschlüsselung aller Mappings und ihrer Komponenten.
Zweitens bewertet er die Komplexität der Jobs. Jeder ETL- oder SQL-Job wird analysiert und kategorisiert (z. B. von LOW bis VERY COMPLEX), auf Basis vordefinierter Regeln und Schwellenwerte für das jeweilige Quellsystem. Das ergibt eine grobe, aber praktische Einschätzung, wie schwierig die Migration jedes Objekts wird. In unserem konkreten Fall für Informatica PowerCenter liefert er einen Komplexitätswert für jedes Mapping und Mapplet auf Basis von:
- Gesamtzahl der Knoten
- Vielfalt der Transformationstypen (z. B. Source Qualifier, Joiner, Aggregator, Lookup)
- Vorhandensein komplexer Transformationen
- Ausdruckstiefe (z. B. Anzahl der Ausdrücke mit 5 oder mehr Funktionsaufrufen)
- Anzahl der Category Breaks mittlerer/hoher Stufe
Schließlich macht er Abhängigkeiten im gesamten System sichtbar. Der Analyzer bildet ab, wie Mappings, Komponenten und Workflows zusammenhängen. So lassen sich Ausführungsreihenfolge und Upstream-/Downstream-Beziehungen leichter verstehen. Das ist besonders wichtig bei der Planung von Migrationswellen, denn wer ein Teil isoliert verschiebt, kann leicht etwas anderes kaputt machen, wenn Abhängigkeiten nicht berücksichtigt sind.
Zusammen machen diese Ergebnisse aus großen, schwer interpretierbaren ETL-Metadaten eine deutlich strukturiertere und verständlichere Sicht und bieten eine solide Grundlage für die Planung, was in welcher Reihenfolge und mit welchem Aufwand migriert wird.
Diese Erkenntnisse beschleunigen die technische Bestandsaufnahme erheblich, beschränken sich aber auf das, was sich aus Quellmetadaten ableiten lässt. Sie müssen mit fachlichen und architektonischen Überlegungen kombiniert werden, um die endgültigen Migrationsentscheidungen zu treffen.
In unserem Fall half uns das Ergebnis des Analyzer, den technischen Umfang einzugrenzen und eine repräsentative Teilmenge von Mappings auszuwählen, die wir in der Transpilierungsphase genauer bewertet haben.
Unser Vorgehen
Zuerst haben wir den Informatica-Workflow-Ordner in einen lokalen Workspace extrahiert. Mit dem Lakebridge Analyzer haben wir dann aus den Metadaten des Workflow-Ordners ein Excel-Inventar erzeugt und den Bericht im Detail geprüft. Auf Basis dieser Analyse haben wir 4 Informatica-Mappings unterschiedlicher Komplexität (LOW, MEDIUM, HIGH und VERY COMPLEX) ausgewählt, um alle Muster und Komponenten mit dem Lakebridge Transpiler gründlich zu bewerten.
Weitere Details zu Einrichtung und Nutzung des Lakebridge Analyzer finden Sie unter diesem Link.
Transpilierungsphase: Lakebridge Transpiler
Ist das Assessment abgeschlossen und haben wir entschieden, welche ETL-Workloads zuerst migriert werden, folgt die Umwandlung ihrer Logik in Databricks-kompatiblen Code.
Für jedes Mapping in Informatica PowerCenter müssten wir sonst jede Komponente einzeln durchgehen: Transformationen analysieren, Logik dokumentieren, Ein- und Ausgaben nachverfolgen und dann alles in Databricks-kompatiblem Code neu implementieren. Wie Sie sich vorstellen können, ist das sehr zeitaufwendig und fehleranfällig – Abhängigkeiten oder subtile Transformationslogik übersieht man dabei leicht.
In Databricks Lakebridge vereinfacht der Lakebridge Transpiler dieses Vorgehen erheblich, indem er den Großteil der manuellen Arbeit automatisiert. Statt Pipelines von Hand nachzubauen, parst er die Quellartefakte und erzeugt gleichwertigen Code für Databricks. Was normalerweise Stunden oder sogar Tage dauert, lässt sich auf Minuten verkürzen – und Struktur und Absicht des ursprünglichen Mappings bleiben erhalten.
Um zu verstehen, wie das unter der Haube funktioniert, lohnt ein Blick auf das Design des Transpilers. Lakebridge nutzt das Language Server Protocol (LSP), um zur Laufzeit verschiedene Transpiler zu finden und auf die bereitgestellten Quellcodedateien anzuwenden. Dieser modulare Ansatz ermöglicht mehrere Konvertierungs-Engines, je nach Quellsystem und Workload-Typ.
Derzeit gibt es drei Transpiler: Morpheus, BladeBridge und Switch. Morpheus ist ein deterministisches, auf SQL fokussiertes Tool, das sich gut für einfache reine SQL-Migrationen eignet, etwa von Snowflake oder Redshift. Switch ist eine eher experimentelle, LLM-basierte Option für Fälle, in denen es keinen deterministischen Transpiler gibt.
BladeBridge ist für unseren Anwendungsfall jedoch am relevantesten. Es ist ein deterministischer, konfigurationsgesteuerter Transpiler, der sowohl SQL- als auch ETL-Workloads unterstützt. Vor allem ist er der einzige Transpiler, der ETL-Workloads aus Informatica PowerCenter XML verarbeitet und Mappings, Sessions und Workflows direkt in Databricks-Artefakte umwandelt: PySpark- oder Spark-SQL-Python-Skripte. Wegen dieser nativen Unterstützung war BladeBridge für unser Migrationsszenario die klare Wahl.
Unser Vorgehen
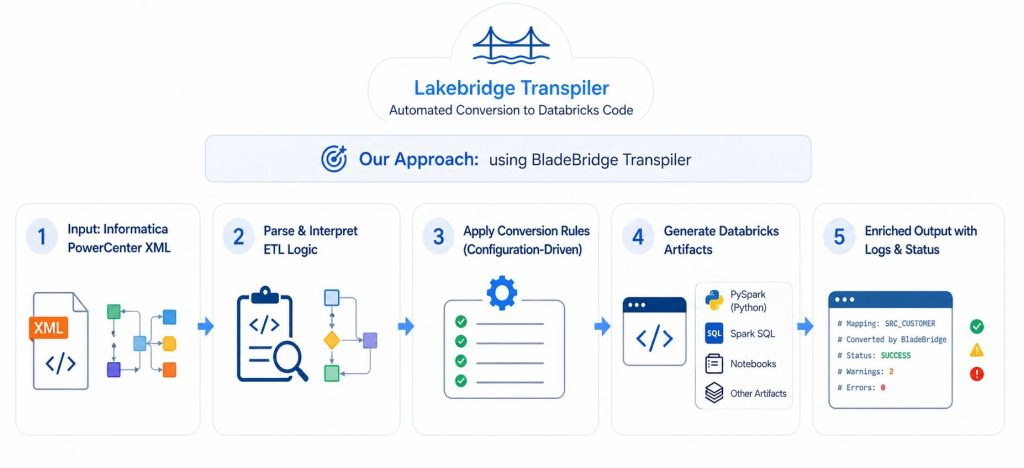
Wir haben jedes ausgewählte Informatica-PowerCenter-XML-Mapping durch den Lakebridge-Transpiler BladeBridge laufen lassen und Databricks-kompatible Ausgaben wie Spark-SQL- und PySpark-Skripte erzeugt.
Der BladeBridge-Transpiler nimmt jedes exportierte XML-Mapping, parst und interpretiert die zugrunde liegende ETL-Logik und erzeugt dann mit einem Satz konfigurationsgesteuerter Konvertierungsregeln gleichwertige Ausgaben im Zielformat – etwa Notebooks, Spark SQL, PySpark-Skripte und andere Databricks-Artefakte.
Die erzeugte Ausgabe folgt so eng wie möglich der Struktur der Eingabe. So lässt sich leichter nachvollziehen, wie Quellkomponenten auf den konvertierten Code abgebildet werden. Zusätzlich reichert der Transpiler die Ausgabe mit Header-Kommentaren und Logs an, die den Konvertierungsstatus festhalten – Erfolge, Warnungen und Fehler – und so Stellen aufzeigen, die manuell angepasst werden müssen.
Weitere Details zu Einrichtung und Nutzung des Lakebridge Transpiler finden Sie unter diesem Link.
Bewertung des Lakebridge Transpiler
Nachdem die repräsentativen XML-Mappings erfolgreich transpiliert waren, ging es darum, die erzeugte Logik der transpilierten Skripte zu bewerten. Wir wollten Fragen beantworten wie:
- Funktioniert die erzeugte Logik tatsächlich?
- Wie genau entspricht sie dem ursprünglichen ETL-Verhalten?
- Wo liegen Lücken oder Grenzen?
Dieses Kapitel bietet eine umfassende Analyse der Transpilierungsergebnisse von BladeBridge: wo es starke Ergebnisse liefert, wo es Schwierigkeiten hat und was Sie wissen sollten, bevor Sie sich bei Ihrer Migration von Informatica zu Databricks darauf verlassen.
Fähigkeiten: Wo das Tool überzeugt
Schnelle erste Konvertierung
Einer der größten Vorteile von BladeBridge ist die Geschwindigkeit, mit der Sie eine erste lauffähige Version Ihrer Migration erhalten. Was normalerweise Tage manueller Konvertierung kostet, ist in wenigen Minuten (1–5 Minuten) erledigt. Der Transpiler verarbeitet Ihr gesamtes Mapping und erzeugt eine PySpark- oder Spark-SQL-Variante – eine solide Grundlage für die weitere Arbeit.
Trennung Komponente für Komponente
Bei transpilierten Skripten fällt zuerst auf, dass alle Informatica-Komponenten der Reihe nach abgebildet sind, mit klaren Kommentaren zum ursprünglichen Informatica-Typ, Knotennamen, einer zusätzlichen Beschreibung und optionalem Fehlerstatus. Das erleichtert den Abgleich, welche Spark-Logik für welche Informatica-Komponente verwendet wurde, erheblich – man kann der Logik leicht folgen und Stellen erkennen, die Aufmerksamkeit brauchen.
...
# COMMAND ----------
# Processing node DIM_METRICS, type SOURCE
# COLUMN COUNT: 8
...
# COMMAND ----------
# Processing node fil_dim_metrics_data, type FILTER
# COLUMN COUNT: 8
...
# COMMAND ----------
# Processing node metrics_IN, type ROUTER . Note: using additional SELECT to rename incoming columns
# COLUMN COUNT: 35
...
Robuste Unterstützung gängiger Transformationen
Die meisten Standard-Transformationen von Informatica werden mit wenig oder gar keinem manuellen Eingriff korrekt transpiliert. Syntaxprobleme treten vor allem bei individueller SQL-Logik und komplexen Ausdrücken auf. Eine ausführlichere Liste der Probleme folgt in einem späteren Abschnitt.
Hier eine Liste der Komponenten in unseren transpilierten Python-Skripten mit einer kurzen Einschätzung der Qualität ihres transpilierten Codes:
| Komponente | Qualität der Transpilierung | Kurzer Überblick |
|---|---|---|
| Source Qualifier | Hoch | Übernimmt SQL unverändert (manchmal ist manuelles Refactoring nötig), fügt eine Spalte sys_row_id/source_record_id hinzu. |
| Target | Mittel | Einfaches Append/Overwrite. Für Upsert-/Merge-Anweisungen ist zusätzliches Refactoring nötig. |
| Aggregator | Sehr hoch | Verarbeitet GROUP BY und Aggregationen gut. |
| Expression | Mittel | Wandelt die meisten SQL-Ausdrücke korrekt um, bei komplexerer Logik ist Databricks-spezifische Optimierung nötig. |
| Filter | Sehr hoch | Einfache Übersetzung der WHERE-Klausel. |
| Joiner | Sehr hoch | Einfache Übersetzung des JOIN. |
| Router | Mittel | Filterbasiertes Routing funktioniert gut. Erzeugt mehrere große Routing-Abschnitte, die manchmal schwer zu überblicken und zu verstehen sind. |
| Sorter | Sehr hoch | Einfache Übersetzung von ORDER BY. |
| Union | Hoch | Einfache Übersetzung der UNION-Operation. UNION ALL und UNION müssen manuell unterschieden werden. |
| Mapplet | Mittel | Wird in wiederverwendbare Funktionen umgewandelt, die unabhängig getestet werden sollten. |
| Input (Mapplet), Output (Mapplet) | Hoch | Wird korrekt verarbeitet, mit passender Spaltenzuordnung und erwarteter Ein- und Ausgabestruktur. |
| Lookup | Mittel | Teilweise unterstützt. PySpark funktioniert gut, Spark SQL braucht manuelle Korrekturen. |
| Custom Transformation | Nicht unterstützt | Nicht zuverlässig unterstützt. Erfordert manuelle Validierung. |
| Sequence (Generator), Transaction Control, SQL Transformation, Stored Procedure, Java Transformation | Nicht unterstützt | Nicht unterstützt. Erfordert ein Redesign mit nativen Databricks-Funktionen. |
Beispiel – Filter Transformation:
# PySpark
filter(expr(f"""IF (CURRENT_FLAG = '{'{p_flag_yes}'}' AND LOCATION_ID != - 1, true, false)"""))
# Spark_SQL
WHERE IF(exp_setinput_dim.CURRENT_FLAG = {'{p_flag_yes}'} AND exp_setinput_dim.LOCATION <> - 1, TRUE, FALSE)
Intelligente Behandlung von Mapplets
Bei Mapplets in Informatica wandelt der BladeBridge-Transpiler die Mapplet-Logik in Python-Funktionen um, die mit übergebenem DataFrame und Metadaten aufgerufen werden können. Wer die Mapplet-Funktion validiert, macht sie damit automatisch für alle anderen Mappings gültig, die dasselbe Mapplet nutzen – die bestehende Informatica-Logik bleibt erhalten und wird weiter genutzt.
Beispiel:
mplt_UserPassword_Masking = mplt_UserPassword_Masking(mplt_UserPassword_Masking_INPUT)
def mplt_UserPassword_Masking(INPUT):
    # Mapplet logic becomes a reusable function
    # Expression, Joiner, Filter components inside
    return output
Intelligente hashbasierte Zeilenidentifikation
Für Source- und Lookup-Komponenten und manchmal auch andere fügt BladeBridge eine xxhash64-Spalte hinzu, die jede Zeile anhand aller Spaltenwerte eindeutig identifiziert. Das ist besonders hilfreich, wenn Lookup-Komponenten in PySpark in zwei Join-DataFrames transpiliert werden, weil die Hash-Spalte schnellere Joins ermöglicht.
Grenzen: Wo manuelle Eingriffe nötig sind
Die meisten Komponenten der transpilierten Skripte funktionieren, bestimmte Komponenten und Muster müssen aber manuell nachgebessert werden. Die häufigsten Punkte, auf die Sie achten sollten:
Lookup-Komponenten in Spark SQL
Lookup-Transformationen werden in PySpark korrekt transpiliert, die Spark-SQL-Ausgabe ist jedoch oft fehlerhaft und braucht umfangreiches Refactoring.
Das Hauptproblem ist der übermäßige Einsatz der Funktion xxhash64, um für jede Quelle, jede Lookup-Tabelle und sogar Zwischentabellen eine eindeutige Spalte source_record_id zu erzeugen – und anschließend eindeutige Hashes verschiedener Tabellen mit unterschiedlichen Spalten per JOIN zu verknüpfen.
Die Lösung: denselben Hashing-Ansatz für source_record_id wie in PySpark verwenden. Wird die Spalte source_record_id mit xxhash64 nur in den Quelltabellen erzeugt und beim Join von Lookup-Tabellen mit Quelltabellen dieselbe Spalte source_record_id für spätere Joins mit weiteren Lookup-Tabellen beibehalten, werden die Lookup-Joins effizienter und die bisher fehlerhafte Logik behoben.
Informatica-spezifische Komponenten
Mehrere Informatica-spezifische Transformationen lassen sich nicht sauber übersetzen und erfordern nach der Transpilierung manuelle Eingriffe.
- Sequence Generator ist nicht korrekt umgesetzt – BladeBridge fügt typischerweise
seq_primary_key.NEXTVALein, wofür es in Spark keine direkte Entsprechung gibt. In Databricks sollte das durch eine SpalteGENERATE ALWAYS AS IDENTITYim CREATE-Statement der Zieltabelle ersetzt werden. Für MERGE-basierte Pipelines ist zusätzliche individuelle Logik nötig. - Java Transformations werden gar nicht konvertiert. Der Transpiler lässt sie entweder auskommentiert oder markiert nur ihr Vorhandensein, ohne ausführbaren Code zu erzeugen. Sie müssen Fall für Fall komplett manuell neu implementiert werden.
- Update Strategy ist Informatica-spezifisch und in Databricks nicht anwendbar. BladeBridge fügt oft unnötige Spalten wie
UPDATE_STRATEGY_ACTIONoderpyspark_data_actionein, die entfernt werden sollten, weil sie keinen funktionalen Zweck haben.
Oracle-/Informatica-spezifische Syntax
Bei individuellen SQL-Anweisungen mit Oracle- oder Informatica-spezifischer Syntax (Variablen, Speicherangaben wie Partitionierung/Caching) lässt der Transpiler das SQL unverändert. Die Entwickler müssen es manuell an Databricks anpassen.
Beispiele:
- Sequenzreferenzen (
seq_name.NEXTVAL) - Oracle-spezifische Funktionen
- Partitions-/Cluster-Angaben
...
SELECT ... FROM
 D_LOCATIONS partition ('{partition_id}')
 WHERE
 ...
- Cache-Direktiven
Fest codierte Pfade
Fest codierte Pfade, die im Informatica-Quellsystem funktioniert haben, werden unverändert in die PySpark-Struktur übernommen. Damit diese Logik korrekt funktioniert, muss dieselbe Datei an einem von Databricks unterstützten Speicherort (etwa Object Storage oder einem Volume) angelegt und der referenzierte Pfad entsprechend angepasst werden:
# Before (wrong)
dt = spark.read.format("csv").load('/root/local/workflow/path/file.csv')
# After (correct)
dt = spark.read.format("csv").load('Volume/workflow/path/file.csv')
Probleme mit der Parametersyntax
Der Transpiler behält manchmal fehlerhafte Parameterreferenzen bei, die nicht dem von Databricks erwarteten Format entsprechen. Das lässt sich leicht mit einem globalen Ersetzen der fehlerhaften Variablensubstitutionen durch die korrekte Syntax beheben.
Beispiel:
{{('param_name')}} durch '{param_name}' ersetzen
Syntaxfehler in Ausdrücken
In seltenen Fällen führt Lakebridge beim Transpilieren von Ausdruckslogik Fehler ein – mit falscher Syntax, uneinheitlicher Formatierung oder falsch behandelten Escape-Zeichen:
Beispielfehler und passende Korrekturen:
TO_DATE('2.1.2023','dd.MM.y')zuTO_DATE('02.01.2023','dd.MM.y')ändernDECODE ( EXP_ID IS NULL = false)zuDECODE ( EXP_ID IS NOT NULL)ändern- Leere
IN-Klausel:lkp_locations.LOCATION_NAME IN ( )- mit dem Original-XML vergleichen und die nötigen Korrekturen vornehmen
- Falsche Datums-/Zeitformatierung je nach Spalte:
mm/dd/yyyy hh24:mi:ssdurchMM/dd/y HH:mm:ssersetzen für die SpalteUPDATE_TIMESTAMP - …
Fazit
Die Migration der ETL-Logik von einem Legacy-Data-Warehouse in ein Lakehouse ist eine der komplexesten Phasen der gesamten Migration, wenn nicht die komplexeste. ETL-Pipelines sind oft groß und komplex, mit umfangreicher Transformationslogik, voneinander abhängigen Workflows und plattformspezifischen Anpassungen. Eine manuelle Migration ist daher langsam und fehleranfällig: Datenflüsse müssen sorgfältig nachverfolgt, Abhängigkeiten entwirrt und Logik neu geschrieben werden – oft mit Inkonsistenzen und übersehenen Randfällen.
Genau hier werden Tools wie Databricks Lakebridge unverzichtbar. Sie machen aus einer kompletten manuellen Neuentwicklung einen strukturierteren und weitgehend automatisierten ETL-Modernisierungsprozess. Unserer Bewertung nach senkt Lakebridge den anfänglichen Aufwand deutlich, indem es die Komplexität analysiert und strukturierten PySpark- oder Spark-SQL-Code erzeugt, der eng an der ursprünglichen Logik ausgerichtet ist. Ein Teil der Arbeit erfordert wegen der realen Komplexität weiterhin manuelle Verfeinerung, doch insgesamt können sich Teams stärker auf Optimierung und Produktionsreife konzentrieren.
Im dritten Blog der Serie haben wir den ETL-Migrationsprozess weiter verbessert und automatisiert, indem wir Lakebridge um Jarvis, das interne LLM-Tool von CROZ, ergänzt haben. Jarvis half uns, den transpilierten Code zu verfeinern, verbleibende Lücken zu schließen und die Pipelines näher an die Produktionsreife zu bringen.
Falls Sie Fragen haben, sind wir nur einen Klick entfernt.